Článek vychází z knihy Inference Engineering Philipa Kielyho, kterou vydalo Baseten Books a která je zdarma dostupná v elektronické podobě. Kiely v ní vysvětluje provoz generativních modelů od výpočetních operací přes správu paměti až po škálování infrastruktury. Následující text shrnuje její základní principy se zaměřením na jazykové modely.
Inference je výpočet výstupu pomocí již natrénovaného modelu. U jazykového modelu zahrnuje zpracování vstupu a postupné generování odpovědi. Inference inženýring řeší, jak tento proces provozovat s požadovanou rychlostí, kvalitou, dostupností a náklady. Samotné načtení vah do paměti GPU je pouze začátek.
Kiely rozděluje tuto práci do tří vrstev. Runtime zajišťuje efektivní běh modelu na jedné instanci, případně tvořené několika GPU. Infrastruktura řeší repliky, rozdělování provozu a dostupnost napříč clustery či regiony. Nástroje poskytují vývojářům prostředky k nasazování, měření a správě. Rychlý výpočetní kernel nevyřeší dlouhou frontu požadavků a další replika nemusí napravit neefektivní práci s pamětí.
Optimalizace začíná požadavky aplikace
První kapitola knihy začíná otázkou, co má nasazení splňovat. Je nutné znát požadovanou kvalitu modelu, časový rozpočet celé aplikace, očekávanou souběžnost i přijatelné náklady. Bez těchto údajů nelze určit, zda je důležitější krátká odezva jednoho požadavku, nebo velký objem zpracovaných dat.
Kiely rozdíl ukazuje na modelu Whisper. Stejný model může obsluhovat průběžné diktování i dávkový přepis zvukového archivu. Diktování vyžaduje nízkou latenci; u archivu rozhoduje množství zpracovaného zvuku za hodinu. Při dostatečném provozu proto dává smysl vytvořit dvě samostatná nasazení s odlišným nastavením, přestože používají stejné váhy.
Autor také rozlišuje sdílenou službu placenou podle spotřeby a vyhrazené nasazení placené podle využívaného hardwaru. Nejde o totéž jako rozdělení na otevřené a uzavřené modely. Model s dostupnými vahami lze používat přes sdílené API. Vlastní nasazení má podle Kielyho smysl tehdy, když je odůvodní objem provozu, specializace nebo požadavky na propojení více modelů. Přináší kontrolu, ale také provozní odpovědnost a minimální průběžné náklady.
Nejdůležitější optimalizační rozhodnutí přitom často předchází výběru hardwaru: který model skutečně potřebujeme. Kniha doporučuje hledat nejmenší model, který spolehlivě zvládne konkrétní úlohu. Jako příklad uvádí převod přirozeného jazyka do SQL, kde může menší specializovaný model nahradit výrazně větší univerzální model. Podmínkou jsou vlastní evaluační testy odpovídající aplikaci. Umístění ve všeobecném benchmarku takovou záruku neposkytuje.
Prefill a dekódování zatěžují hardware odlišně
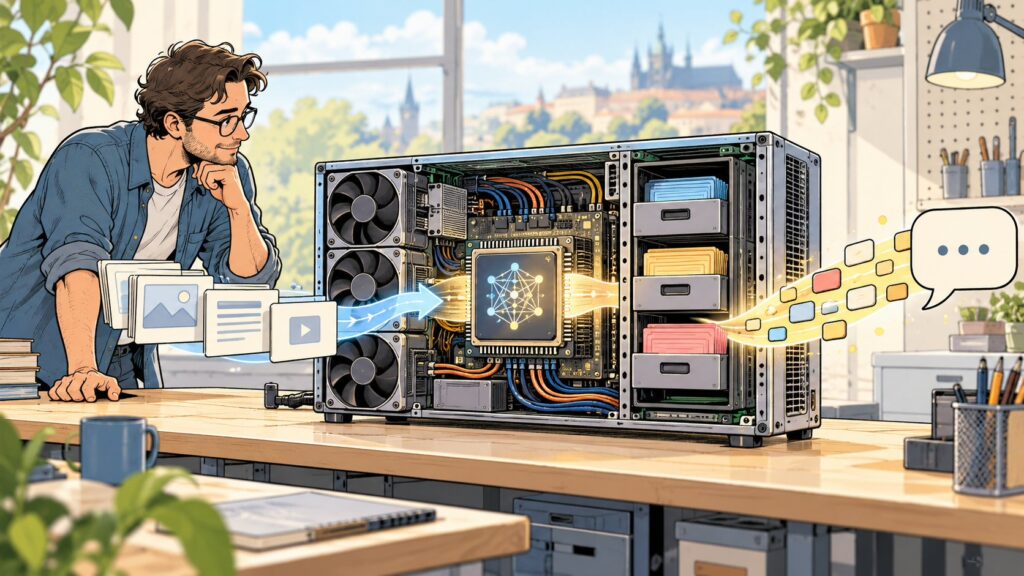
Jazykový model nejprve zpracuje vstupní sekvenci ve fázi prefill. Protože jsou vstupní tokeny již známé, lze výpočty nad jejich pozicemi do značné míry provádět paralelně. Následuje dekódování: model vytvoří další token, připojí jej k dosavadní sekvenci a pokračuje dalším krokem.
Tento rozdíl vysvětluje, proč výkon GPU nelze posuzovat jen podle počtu operací za sekundu. Prefill nabízí rozsáhlejší maticové operace a často dokáže výpočetní jednotky dobře zaměstnat. Při dekódování malé dávky požadavků vzniká méně výpočtů vzhledem k objemu načítaných vah. Omezením pak bývá propustnost paměti.
Kiely vztah vysvětluje pomocí aritmetické intenzity, tedy počtu operací připadajících na přenesený bajt. V příkladu pro H100 uvádí výkon 989 TFLOPS v FP16 a propustnost paměti 3,35 TB/s. Jejich poměr činí přibližně 295 operací na bajt. Výpočet s výrazně nižší aritmetickou intenzitou nedokáže teoretický výpočetní výkon využít, protože jej omezuje přísun dat.
Jde o model pro pochopení omezení, nikoli o předpověď rychlosti konkrétní aplikace. Skutečné chování závisí na architektuře modelu, délce sekvence, velikosti dávky a implementaci operací. Rozdělení na výpočetně omezený prefill a paměťově omezené dekódování je užitečné vodítko, nikoli bezvýjimečné pravidlo.
KV cache: záleží i na pořadí vstupu
Při prefill vzniká KV cache, která uchovává reprezentace klíčů a hodnot používané mechanismem attention. Během dekódování se rozšiřuje o nové tokeny. Model díky ní nemusí tyto reprezentace předchozího kontextu při každém kroku znovu počítat. Úspora výpočtu je vykoupena spotřebou paměti, která roste s délkou sekvencí a jejich souběžným počtem.
Kniha odlišuje toto základní použití od prefix cachingu, tedy opakovaného využití společného začátku mezi požadavky. Pokud několik dotazů začíná stejnými systémovými instrukcemi nebo dokumentem, lze již vypočtenou část KV cache znovu použít a zkrátit prefill.
Rozhodující je přesná shoda od začátku sekvence. Kiely upozorňuje, že první odlišný token ukončuje společný prefix. Shodný text za ním už běžný prefix caching nevyužije, protože jeho reprezentace závisí také na předchozím kontextu.
To má přímý dopad na sestavení vstupu. Stabilní instrukce a společné podklady je výhodné umisťovat před proměnlivou část, pokud to struktura úlohy dovoluje. Vložení jedinečného údaje na začátek může znemožnit využití cache pro dlouhý následující text.
Batching a další zásahy do výpočtu
Batching sdružuje požadavky, aby načtené váhy posloužily většímu množství výpočtů. Zvyšuje tím aritmetickou intenzitu a může zlepšit celkovou propustnost. U generování textu však jednotlivé odpovědi končí v různou dobu.
Continuous batching proto pracuje průběžně na úrovni generovacích kroků. Dokončené požadavky opouštějí dávku a jejich místo obsazují nové. Kniha tento přístup popisuje u inference enginů vLLM, SGLang a TensorRT-LLM. Velikost dávky je přesto nutné měřit: vyšší souhrnná propustnost může znamenat pomalejší generování pro jednotlivého uživatele.
Další techniky zasahují do reprezentace nebo průběhu výpočtu. Kvantizace snižuje přesnost vybraných dat, čímž šetří paměť a může urychlit zpracování. Vyžaduje však ověření kvality výstupů. Spekulativní dekódování navrhuje několik tokenů levnějším postupem a nechává hlavní model návrh ověřit. Přínos závisí na úspěšnosti návrhů i režii ověřování.
Kiely výslovně upozorňuje, že optimalizace se nemusejí sčítat. Spekulativní dekódování například může ztrácet výhodu při velkých dávkách, které již dostupný výpočetní výkon účinně využívají.
Benchmark musí odpovídat provozu
Výkon je nutné měřit na realistických vstupech. Kniha požaduje zohlednit délky vstupních a výstupních sekvencí, souběžnost, nepravidelnost provozu i skutečný obsah dotazů. Ten ovlivňuje úspěšnost prefix cachingu i přijímání spekulativně navržených tokenů. Opakování jednoho krátkého dotazu proto může vytvořit zavádějící výsledek.
Vedle propustnosti je třeba sledovat dobu do prvního tokenu, rychlost dalšího generování a percentily latence. Nejprve vznikne výchozí měření, následně se ověřují jednotlivé změny i jejich kombinace. Benchmarking ukazuje výsledné chování; profiling pomáhá zjistit, ve kterých operacích se čas spotřeboval.
Na tato měření navazuje škálování. Provozovatel potřebuje vědět, kolik souběžných požadavků replika zvládne při přijatelné latenci a jak dlouho trvá spuštění další. Pomalé starty komplikují reakci na špičky a nutí držet rezervní kapacitu. Právě zde se propojuje optimalizace modelu s provozem: úspora na jednom požadavku má hodnotu teprve tehdy, když ji systém udrží při skutečném zatížení.